Domain nagelstudioeinrichtung.de kaufen?
Wir ziehen mit dem Projekt
nagelstudioeinrichtung.de um.
Sind Sie am Kauf der Domain
nagelstudioeinrichtung.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain nagelstudioeinrichtung.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
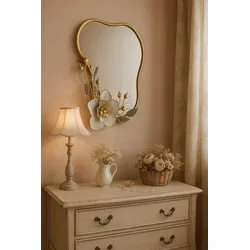
möbel direkt online Wandspiegel mit Dekoration goldfarbenDer romantische Wandspiegel verbindet stilvolle Eleganz mit dekorativem Charme und wird zum besonderen Blickfang in jedem Wohnbereich. Der goldfarben beschichtete Metallrahmen verleiht dem Spiegel eine edle Ausstrahlung, während die aufwendig gearbeitete B69,99 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
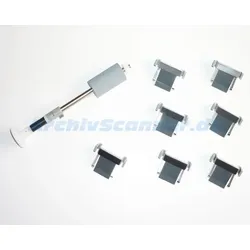
Verbrauchsmaterialien-Kit für Fujitsu SP-1425Verschleißteilekit - Consumable Kitpassend für folgenden Scanner: Fujitsu SP-1425 1 Kit beinhaltet: 1x Einzugsroller – Pick Roller 7x Papierseparationseinheiten – Pad AssemblyLebensdauer: 200.000 Blatt oder ein Jahr Bei den Angaben zur Haltbarkeit und Lebensdauer handelt es sich um unverbindliche Angaben, die wir im Namen des Herstellers weitergeben. Herstellernummer: CON-3753-100K277,00 €*Versand: 5,80 €Sichere Weiterleitung zum Anbieter
-
Verbrauchsmaterialien-Kit für Fujitsu fi-5015CVerschleißteile-Kit - Consumable Kit 1 Kit beinhaltet:1 x Pick Roller (PA03209-0551)5 x Pad Assy (PA03209-0550)passend für folgenden Scanner:Fujitsu fi-5015CLebensdauer 100.000 Blatt oder ein JahrBei den Angaben zur Haltbarkeit und Lebensdauer handelt es sich um unverbindliche Angaben, die wir im Namen des Herstellers weitergeben.Herstellernummer: CON-3209-100K92,46 €*Versand: 5,80 €Sichere Weiterleitung zum Anbieter
-
Verbrauchsmaterialien-Kit für Fujitsu ScanSnap iX1300Verschleißteile-Kit - Consumable Kitpassend für folgende Scanner:Fujitsu ScanSnap iX13001 Verschleißteilekitbeinhaltet:1 x Pick Roller - Einzugsroller3 x Pad Unit - TrenneinheitHerstellernummer: CON-3805-090K80,00 €*Versand: 5,80 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **

Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Informationsextraktion:
-
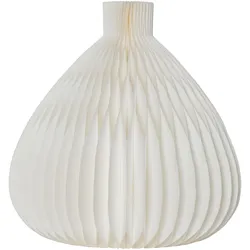
Star Trading, Beleuchtung Zubehör, Hängende Dekoration HoneycombDie hängende Dekoration Honeycomb von Star Trading ist ein eleganter Lampenschirm, der aus umweltfreundlichem FSC-Papier gefertigt ist. Mit einem Durchmesser von 38 cm und einer Höhe von 40 cm bietet dieser Lampenschirm eine ansprechende Bienenwaben-Optik, die jedem Raum eine gemütliche Atmosphäre verleiht. Das faltbare Design ermöglicht eine einfache Handhabung und Lagerung, während die Möglichkeit, ihn mit einem E14 Leuchtmittel zu kombinieren, für eine individuelle Lichtgestaltung sorgt. Diese Hängedekoration eignet sich ideal für den Innenbereich und kann in verschiedenen Räumen wie Wohnzimmer, Esszimmer oder Schlafzimmer eingesetzt werden. Sie ist nicht nur eine funktionale Lichtquelle, sondern auch ein stilvolles Dekorationselement für besondere Anlässe wie Feiern oder Hochzeiten. - Hergestellt aus nachhaltigem, recyceltem FSC-Papier - Faltbares Design für einfache Lagerung und Transport - Vielseitig einsetzbar in verschiedenen Innenräumen - Einfache Montage und Wiederverwendbarkeit - Moderne Bienenwaben-Optik für ansprechende Raumgestaltung.25,89 €*Versand: 3,00 €Sichere Weiterleitung zum Anbieter
-
möbel direkt online Wandspiegel mit Dekoration goldfarbenDer romantische Wandspiegel verbindet stilvolle Eleganz mit dekorativem Charme und wird zum besonderen Blickfang in jedem Wohnbereich. Der goldfarben beschichtete Metallrahmen verleiht dem Spiegel eine edle Ausstrahlung, während die aufwendig gearbeitete B69,99 €*Versand: 5,95 €Sichere Weiterleitung zum Anbieter
-
Verbrauchsmaterialien-Kit für Fujitsu SP-1425Verschleißteilekit - Consumable Kitpassend für folgenden Scanner: Fujitsu SP-1425 1 Kit beinhaltet: 1x Einzugsroller – Pick Roller 7x Papierseparationseinheiten – Pad AssemblyLebensdauer: 200.000 Blatt oder ein Jahr Bei den Angaben zur Haltbarkeit und Lebensdauer handelt es sich um unverbindliche Angaben, die wir im Namen des Herstellers weitergeben. Herstellernummer: CON-3753-100K277,00 €*Versand: 5,80 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Informationsextraktion
-
Verbrauchsmaterialien-Kit für Fujitsu fi-5015CVerschleißteile-Kit - Consumable Kit 1 Kit beinhaltet:1 x Pick Roller (PA03209-0551)5 x Pad Assy (PA03209-0550)passend für folgenden Scanner:Fujitsu fi-5015CLebensdauer 100.000 Blatt oder ein JahrBei den Angaben zur Haltbarkeit und Lebensdauer handelt es sich um unverbindliche Angaben, die wir im Namen des Herstellers weitergeben.Herstellernummer: CON-3209-100K92,46 €*Versand: 5,80 €Sichere Weiterleitung zum Anbieter
-
Verbrauchsmaterialien-Kit für Fujitsu ScanSnap iX1300Verschleißteile-Kit - Consumable Kitpassend für folgende Scanner:Fujitsu ScanSnap iX13001 Verschleißteilekitbeinhaltet:1 x Pick Roller - Einzugsroller3 x Pad Unit - TrenneinheitHerstellernummer: CON-3805-090K80,00 €*Versand: 5,80 €Sichere Weiterleitung zum Anbieter
-
Balzer, Jürgen: Café Krümel. Arbeitsbuch Lernfelder 6-8 Arbeitsmaterialien zur individuellen FörderungCafé Krümel. Arbeitsbuch Lernfelder 6-8 Arbeitsmaterialien zur individuellen Förderung , Geschäftsprozesse im Unternehmen & Personalbezogene Prozesse , Batteriemanagementsysteme (BMS) > Batterien, BMS & Brennstoffzellen , Erscheinungsjahr: 201904, Produktform: Leinen, Titel der Reihe: Café Krümel - Arbeitsmaterialien zur individuellen Förderung / Prozesse im Unternehmen##, Autoren: Balzer, Jürgen~Ernst, Regine~Jost, Martin, Redaktion: Hahn, Hans, Seitenzahl/Blattzahl: 215, Keyword: Betriebswirtschaftslehre mit Rechnungswesen; Schülerband; Unterrichtswerke, Fachschema: Betriebswirtschaft / Berufsbezogenes Schulbuch~Geschäftsprozess, Fachkategorie: Betriebswirtschaftslehre, allgemein~Berufsausbildung~Unterricht und Didaktik: Berufsausbildung, Region: Nordrhein-Westfalen, Bildungszweck: Für das Berufseinstiegsjahr~Für die Berufsfachschule, Warengruppe: HC/Berufsschulbücher, Fachkategorie: Schule und Lernen: Buchhaltung, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Westermann Berufl.Bildung, Verlag: Westermann Berufl.Bildung, Verlag: Westermann Berufliche Bildung, Länge: 294, Breite: 210, Höhe: 20, Gewicht: 582, Produktform: Gebunden, Genre: Schule und Lernen, Genre: Schule und Lernen, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: -1, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel, Unterkatalog: Schulbuch, WolkenId: 239155424,50 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.